AI 반도체 NPU와 GPU의 연산 구조 비교, 왜 AI 시대에는 NPU가 주목받을까?
인공지능(AI)이 우리 일상 속으로 빠르게 들어오면서 반도체 기술도 큰 변화를 맞이하고 있습니다. 과거에는 CPU가 대부분의 연산을 담당했고, 이후 그래픽 처리를 위해 GPU가 등장했습니다. 하지만 최근에는 ChatGPT와 같은 생성형 AI, 자율주행, AI 의료기기, 스마트 카메라 등 다양한 분야에서 NPU(Neural Processing Unit)가 핵심 기술로 자리 잡고 있습니다.
그렇다면 CPU, GPU, NPU는 무엇이 다를까요? 단순히 성능이 더 좋은 프로세서일까요? 이번 글에서는 연구소 연구직이나 임베디드 개발자를 위한 관점에서 NPU와 GPU의 연산 구조를 쉽고 재미있게 알아보겠습니다.
AI 반도체가 필요한 이유
컴퓨터는 계산을 매우 빠르게 수행하지만 AI는 기존 프로그램과 조금 다른 방식으로 동작합니다.
예를 들어 사람이 사진을 보고 고양이를 구분하는 것은 어렵지 않습니다. 하지만 컴퓨터는 수백만 장의 사진을 분석하면서 고양이의 귀 모양, 눈, 수염, 몸체 특징 등을 수학적으로 계산해야 합니다.
이 과정에서 가장 많이 수행되는 연산이 바로 행렬(Matrix) 연산입니다.
AI 모델은 수많은 숫자를 행렬 형태로 저장하고, 이를 계속 곱하고 더하는 작업을 반복합니다. 따라서 AI 성능은 결국 얼마나 빠르게 행렬 연산을 수행하느냐에 달려 있다고 해도 과언이 아닙니다.
CPU는 만능이지만 AI에는 비효율적이다
CPU는 컴퓨터의 두뇌입니다.
운영체제 실행, 인터넷 브라우저, 문서 작성, 게임 실행 등 거의 모든 작업을 처리할 수 있도록 설계되었습니다.
CPU의 가장 큰 장점은 다양한 명령을 유연하게 처리할 수 있다는 점입니다.
반면 AI 연산에서는 조금 아쉬운 부분이 있습니다.
CPU는 복잡한 명령을 하나씩 빠르게 수행하는 데 최적화되어 있기 때문에 수천 개의 행렬 곱셈을 동시에 처리하는 작업에는 효율이 떨어집니다.
쉽게 말하면,
한 명의 매우 뛰어난 전문가가 모든 일을 처리하는 구조라고 생각하면 이해하기 쉽습니다.
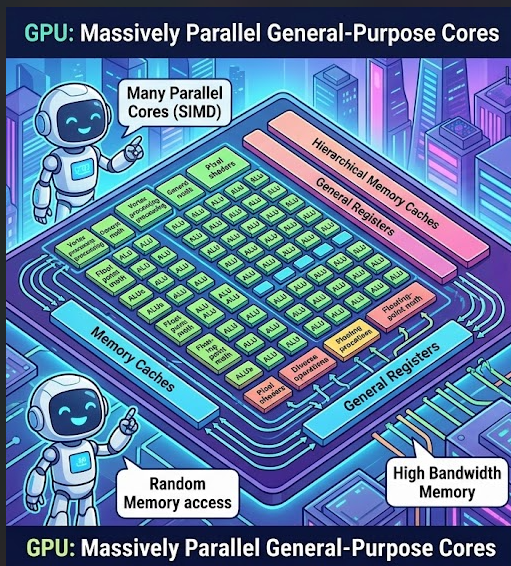
GPU는 병렬 처리의 강자
GPU는 원래 3D 그래픽을 그리기 위해 개발되었습니다.
게임 화면을 보면 수백만 개의 픽셀을 동시에 계산해야 합니다.
그래서 GPU는 수백 개에서 수천 개의 연산 코어를 가지고 있습니다.
덕분에
- 영상 처리
- 이미지 처리
- 머신러닝
- 딥러닝 학습
등에서 엄청난 성능을 발휘합니다.
GPU는 마치 수천 명의 작업자가 동시에 벽돌을 나르는 공사 현장과 비슷합니다.
같은 일을 반복해서 처리할 때 매우 강력합니다.
하지만 GPU 역시 범용 프로세서이기 때문에 AI만을 위해 설계된 구조는 아닙니다.
NPU는 AI만을 위한 전용 프로세서
최근 가장 주목받는 AI 반도체가 바로 NPU입니다.
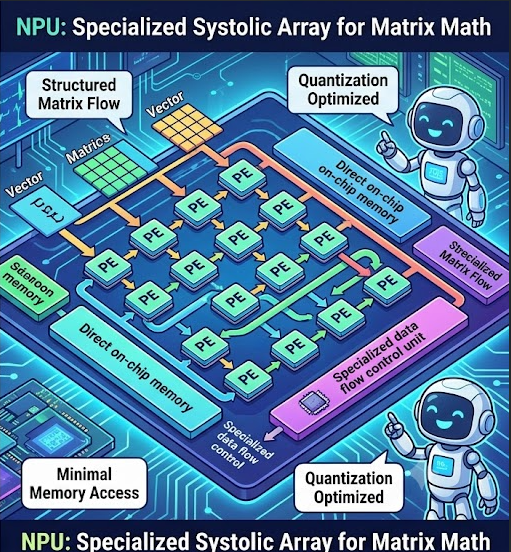
NPU는 이름 그대로 신경망(Neural Network) 계산만을 위해 만들어졌습니다.
즉,
- 행렬 곱셈
- 벡터 연산
- 합성곱(Convolution)
- 활성화 함수 계산
등을 매우 빠르게 수행합니다.
GPU가 만능 공구 세트라면,
NPU는 AI 작업만을 위한 전용 자동화 생산라인이라고 생각하면 됩니다.
그래서 전력 소비는 줄이고 성능은 더욱 높일 수 있습니다.
행렬 연산이 중요한 이유
딥러닝 모델에서는 거의 모든 계산이 행렬 곱셈으로 이루어집니다.
예를 들어
입력 데이터
↓
가중치(Matrix)
↓
출력값
이라는 과정을 수천 번 반복합니다.
이미지 한 장을 인식하는 순간에도 수억 번 이상의 행렬 연산이 발생할 수 있습니다.
그래서 AI 반도체는 행렬 연산을 얼마나 효율적으로 처리하느냐가 가장 중요한 경쟁력입니다.
Systolic Array 구조란?
NPU에서 가장 유명한 구조가 바로 Systolic Array입니다.
이름이 조금 어렵지만 원리는 생각보다 간단합니다.
기존 프로세서는
데이터를 메모리에서 읽고
↓
연산하고
↓
다시 메모리에 저장합니다.
이 과정을 계속 반복합니다.
문제는 연산보다 메모리 접근이 더 느리다는 점입니다.
이를 메모리 병목(Memory Bottleneck)이라고 합니다.
Systolic Array는 데이터를 연산 유닛 사이에서 직접 전달하도록 설계되어 메모리에 접근하는 횟수를 크게 줄입니다.
마치 공장에서 컨베이어벨트가 부품을 다음 작업자에게 바로 전달하는 것과 같은 방식입니다.
덕분에
- 처리 속도 향상
- 전력 절감
- 높은 연산 효율
이라는 장점을 얻을 수 있습니다.
오늘날 구글 TPU를 비롯한 다양한 AI 반도체가 이러한 구조를 활용하고 있습니다.
양자화(Quantization)란 무엇일까?
AI 모델은 일반적으로 32비트 부동소수점(FP32)을 사용합니다.
하지만 모든 계산을 32비트로 수행하면 메모리 사용량이 매우 커집니다.
그래서 등장한 기술이 바로 양자화(Quantization)입니다.
예를 들어
32비트 데이터를
8비트(INT8)
또는
4비트(INT4)
형태로 변환하여 저장합니다.
데이터 크기가 작아지면
- 메모리 사용량 감소
- 연산 속도 향상
- 전력 소비 감소
라는 장점이 생깁니다.
물론 너무 작은 비트로 줄이면 정확도가 떨어질 수 있기 때문에 적절한 균형을 찾는 것이 중요합니다.
최근 스마트폰과 엣지 AI 기기에서는 INT8 양자화가 널리 활용되고 있습니다.
AI 의료기기와 Edge AI에서도 NPU가 중요한 이유
최근 의료기기 역시 AI 기능을 적극적으로 도입하고 있습니다.
예를 들어
- ECG 분석
- PPG 신호 분석
- AI 초음파
- 스마트 청진기
- 웨어러블 의료기기
등에서는 클라우드 서버에 데이터를 보내지 않고 기기 내부에서 AI 추론을 수행하는 경우가 늘고 있습니다.
이러한 Edge AI 환경에서는 전력 소모가 적고 빠르게 추론할 수 있는 NPU가 매우 적합합니다.
또한 개인정보를 외부 서버로 전송하지 않아도 되므로 보안과 개인정보 보호 측면에서도 큰 장점이 있습니다.
앞으로의 AI 반도체 시장 전망
AI 기술이 발전할수록 CPU와 GPU만으로는 모든 요구를 만족시키기 어려워지고 있습니다.
특히 자율주행차, AI 로봇, 스마트 팩토리, 의료기기, 산업용 IoT와 같은 분야에서는 고성능·저전력 AI 연산이 필수 요소가 되고 있습니다.
이러한 변화 속에서 NPU는 단순한 보조 프로세서가 아니라 AI 시대의 핵심 반도체로 자리매김하고 있습니다. 앞으로는 더욱 다양한 MCU와 SoC에 NPU가 기본적으로 탑재될 가능성이 높으며, 연구소 연구원과 임베디드 개발자에게도 NPU 구조와 AI 최적화 기술에 대한 이해는 중요한 경쟁력이 될 것입니다.